La Poste du Burkina Faso
Continuité d'activité et protection des machines virtuelles
Surveillance quotidienne de deux mécanismes de protection complémentaires : la réplication EMC RecoverPoint vers un site distant, suivie par groupes de cohérence et indicateurs RPO/RTO, et les sauvegardes Commvault — tâches, rétention et restaurations.
- Période
- Juillet 2015 – février 2022
- Mon rôle
- Chef de division informatique régional
- Organisation
- La Poste du Burkina Faso
Technologies
- EMC RecoverPoint
- Commvault
- VMware vSphere
- vCenter
- Dell EMC
- PRTG
Sur cette page
Résumé
De 2015 à 2022, j’ai assuré au quotidien la surveillance des mécanismes de protection des données de La Poste du Burkina Faso, une organisation certifiée ISO 9001 comptant 119 agences et plus de 1 100 employés. Deux dispositifs complémentaires couvraient les machines virtuelles : la réplication EMC RecoverPoint vers un site distant, dont je suivais les groupes de cohérence et les indicateurs de point et de temps de reprise, et les sauvegardes Commvault, dont je supervisais les tâches, les politiques de rétention et les restaurations. Mon rôle relevait de l’exploitation et de la surveillance, dans un cadre documenté conforme aux exigences d’audit de la certification.
Contexte technique
Les services métier de La Poste du Burkina Faso, dont l’application de gestion du courrier, étaient hébergés sur une plateforme virtualisée VMware desservant l’ensemble du réseau d’agences. Une interruption prolongée ne se limitait pas à un inconfort interne : elle bloquait des opérations de guichet dans les agences.
Deux risques distincts devaient être couverts, et ils n’appellent pas la même réponse. D’un côté, la perte ou la corruption de données — suppression accidentelle, erreur applicative, altération progressive — pour laquelle il faut pouvoir revenir à un état antérieur, parfois ancien. De l’autre, la perte d’un équipement ou d’un site, pour laquelle il faut une copie distante déjà constituée, aussi proche que possible de l’état courant.
L’infrastructure combinait donc Commvault pour la sauvegarde à rétention longue et EMC RecoverPoint pour la réplication vers un site de reprise, le tout sur du matériel Dell EMC. La certification ISO 9001 imposait que ces opérations soient documentées et vérifiables : les tâches de sauvegarde, les politiques de rétention et le suivi des objectifs de reprise devaient laisser une trace exploitable en audit, et non reposer sur la mémoire de l’exploitant.
Objectifs de protection des systèmes
- Garantir qu’une donnée perdue puisse être retrouvée, à une profondeur d’historique définie par la politique de rétention.
- Maintenir une copie distante exploitable des volumes de production, afin que la perte d’un équipement ou d’un site n’entraîne pas la perte des données.
- Suivre explicitement les objectifs de reprise — point de reprise (RPO) et temps de reprise (RTO) — par groupe de cohérence, plutôt que de les estimer après un incident.
- Détecter sans délai une protection en défaut : tâche de sauvegarde échouée, réplication en retard, groupe de cohérence en erreur.
- Vérifier que les restaurations fonctionnent réellement, une sauvegarde jamais relue n’étant qu’une hypothèse.
- Documenter l’exploitation au niveau d’exigence de la certification ISO 9001.
Mon rôle dans l’exploitation
Chef de division informatique régional, responsable de l’exploitation de la plateforme de virtualisation, de la relève et des sauvegardes. Sur le volet protection des données, mon travail consistait à surveiller, suivre et rendre compte : vérifier chaque jour que les mécanismes en place remplissaient leur fonction, traiter ou faire traiter les anomalies, et porter l’information à la direction lors des incidents.
Mes responsabilités de supervision
- Surveillance de la réplication EMC RecoverPoint : état des liaisons, détection des retards de réplication et des bascules d’état.
- Suivi des groupes de cohérence : vérification que chaque groupe restait dans un état sain et que les volumes attendus y figuraient.
- Surveillance des indicateurs RPO et RTO par groupe de cohérence, et signalement des écarts par rapport aux objectifs fixés.
- Supervision des sauvegardes Commvault : suivi des tâches, traitement des échecs et des tâches en attente.
- Suivi des politiques de rétention appliquées aux différents ensembles de données.
- Suivi des restaurations demandées, de la prise en compte jusqu’à la vérification du résultat.
- Supervision d’infrastructure avec PRTG, afin de détecter les dégradations — dont celles affectant les liaisons utilisées par la réplication — avant leur signalement par les utilisateurs.
- Tenue de la documentation d’exploitation exigée par la certification ISO 9001.
Architectures techniques
1. Architecture de sauvegarde Commvault
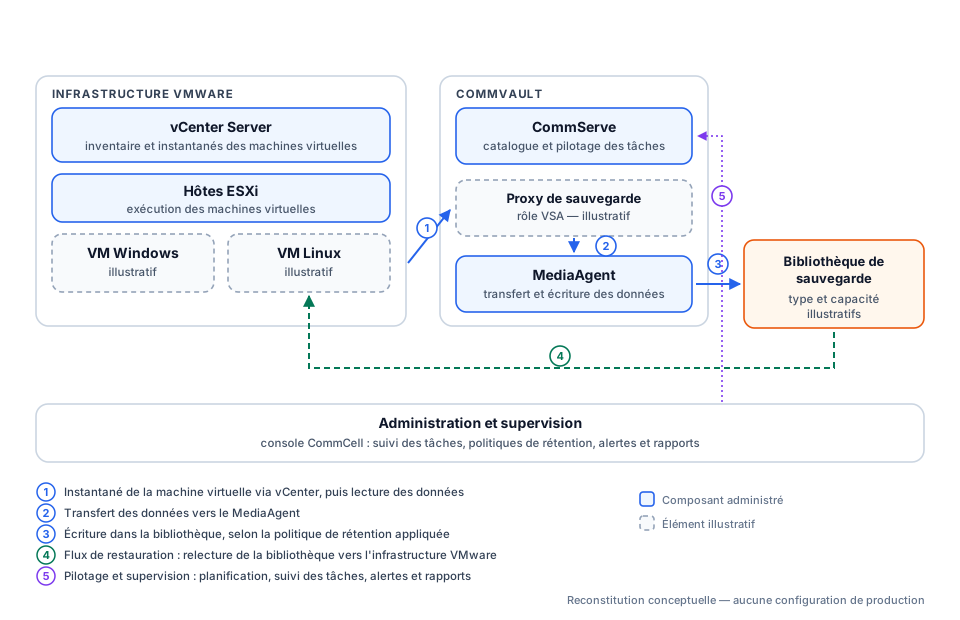
Comment lire ce schéma. La sauvegarde d’une machine virtuelle ne consiste pas à copier un serveur en fonctionnement : on fige d’abord son état par un instantané pris via vCenter, puis on lit les données à partir de cette image figée, ce qui évite d’obtenir un fichier incohérent. Le proxy de sauvegarde assure cette lecture, le MediaAgent transporte et écrit les données, et le CommServe tient le catalogue — c’est-à-dire la liste de ce qui a été sauvegardé, quand, et où cela se trouve. Sans ce catalogue, les données de la bibliothèque existent mais deviennent inexploitables.
Le trajet de restauration (4) emprunte le chemin inverse : la bibliothèque rend les données, qui repartent vers l’infrastructure VMware. La boucle de pilotage (5) est celle que j’exerçais au quotidien — planification, suivi des tâches, alertes et rapports.
2. Architecture de réplication RecoverPoint
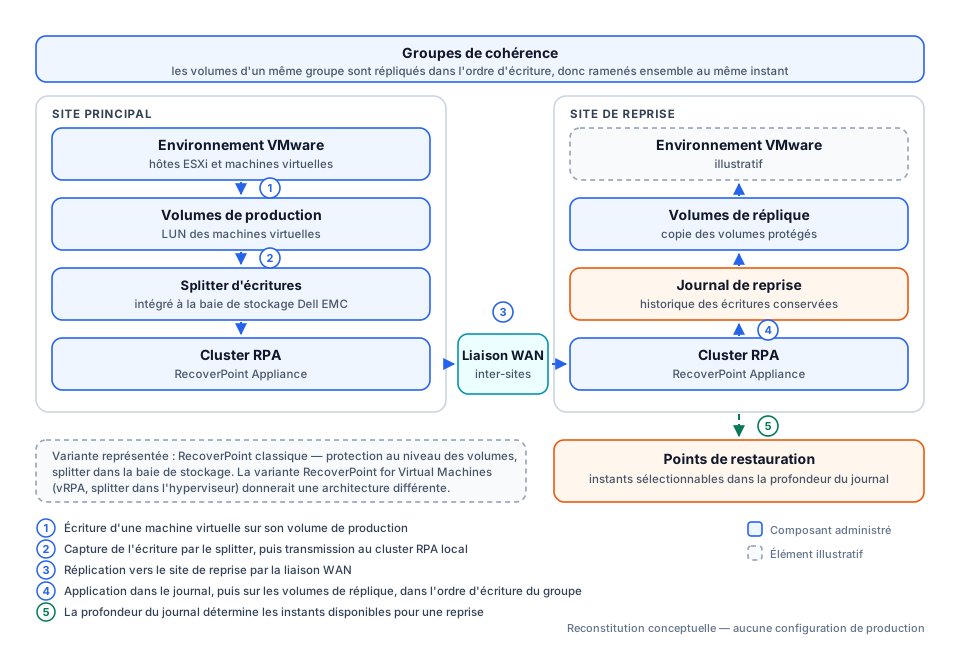
Comment lire ce schéma. Chaque écriture d’une machine virtuelle sur son volume de production est dupliquée au passage par un composant appelé splitter : l’original poursuit sa route vers le disque, la copie part vers le cluster RPA, qui l’expédie au site de reprise. Là-bas, l’écriture n’est pas appliquée directement sur la copie : elle transite d’abord par un journal, qui conserve un historique. C’est ce journal qui permet de revenir non seulement au dernier état connu, mais à un instant antérieur choisi — utile lorsque l’incident est une corruption de données plutôt qu’une panne matérielle.
Cohérence de la variante retenue. Le schéma représente RecoverPoint classique, où la protection porte sur les volumes et où le splitter réside dans la baie de stockage — ce qui est cohérent avec un environnement Dell EMC. L’autre variante du produit, RecoverPoint for Virtual Machines, place des appliances virtuelles (vRPA) et un splitter dans l’hyperviseur ESXi, et protège les machines virtuelles individuellement : les composants du schéma seraient alors différents. Mes CV ne précisent pas la variante exploitée ; le choix de représentation est donc explicite et signalé dans le schéma lui-même, plutôt que présenté comme un fait.
3. Chaîne de continuité d’activité
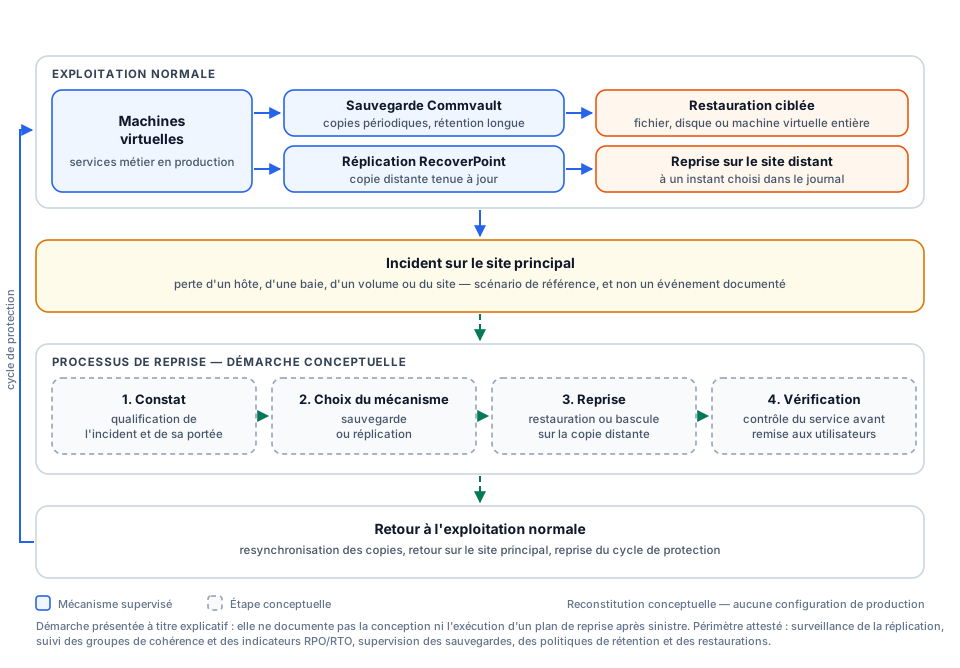
Comment lire ce schéma. La lecture se fait de haut en bas. En haut, l’exploitation normale : une même machine virtuelle est couverte par deux mécanismes qui ne servent pas à la même chose — la sauvegarde ouvre sur une restauration ciblée à rétention longue, la réplication ouvre sur une reprise distante à un instant récent. Au milieu, l’incident, puis la démarche de reprise en quatre étapes. En bas, le retour à l’exploitation, qui referme le cycle : les copies sont resynchronisées et la protection reprend. La flèche de retour, sur la gauche, matérialise ce caractère cyclique — la protection n’est pas un état acquis, c’est une boucle à entretenir.
Explication technique
Sauvegarde et réplication : deux réponses à deux risques
C’est la distinction la plus mal comprise du domaine, et celle qui coûte le plus cher quand elle est ignorée.
La réplication maintient une copie distante aussi proche que possible de l’état courant. Elle protège contre la perte d’un équipement ou d’un site. Mais elle réplique fidèlement ce qui arrive : si une donnée est supprimée ou corrompue sur le site principal, la suppression ou la corruption part vers la copie. Sans mécanisme d’historique, la réplication seule ne protège pas contre l’erreur.
La sauvegarde produit des copies périodiques et conservées dans le temps. Elle protège contre l’erreur, la corruption et la destruction logique, puisqu’on peut revenir à un état antérieur. En revanche elle est plus ancienne par construction : entre deux sauvegardes, les écritures récentes ne sont nulle part.
Les deux sont donc complémentaires, et l’un ne remplace pas l’autre. C’est précisément l’articulation que représente le troisième schéma.
Rôle de Commvault
Commvault est la plateforme de sauvegarde. Le CommServe y joue le rôle de cerveau : il tient le catalogue et déclenche les tâches selon leur planification. Le MediaAgent est le muscle : il déplace les données et les écrit dans la bibliothèque de sauvegarde. Les politiques de rétention déterminent combien de temps chaque copie est conservée, et donc jusqu’où il est possible de remonter dans le passé.
Rôle de RecoverPoint
RecoverPoint assure la réplication. Son principe est la capture des écritures : un splitter duplique chaque écriture vers un cluster RPA, qui l’achemine au site distant. Sa particularité par rapport à une réplication simple est le journal, qui conserve une profondeur d’historique et permet de choisir l’instant de retour, au lieu d’être limité au dernier état connu.
Groupes de cohérence
Une application ne tient presque jamais sur un seul volume : une base de données, par exemple, écrit ses données et son journal de transactions séparément. Si ces deux volumes sont répliqués indépendamment, rien ne garantit qu’ils arrivent à destination dans le bon ordre — et une base restaurée à partir de volumes désynchronisés peut être inutilisable.
Le groupe de cohérence résout exactement cela : les volumes d’un même groupe sont répliqués en respectant l’ordre d’écriture et ramenés ensemble au même instant. C’est pourquoi leur suivi est une tâche d’exploitation à part entière : un volume oublié lors de l’ajout d’un serveur, et la cohérence du groupe n’est plus assurée — sans qu’aucune alarme ne le signale forcément.
RPO et RTO
Deux objectifs distincts, souvent confondus.
Le RPO (Recovery Point Objective) est la quantité de données que l’on accepte de perdre, exprimée en temps : un RPO de quinze minutes signifie qu’après un incident, on peut avoir perdu jusqu’à quinze minutes d’écritures. Il dépend de la fréquence de la protection.
Le RTO (Recovery Time Objective) est la durée d’interruption acceptée avant que le service soit rétabli. Il dépend de la rapidité de la procédure de reprise, pas de la fréquence des copies.
Les deux doivent être fixés par le métier, pas par l’informatique, puis vérifiés en exploitation. Leur suivi par groupe de cohérence — ce que je faisais — consiste à comparer en continu l’écart réel à l’objectif annoncé, et à signaler les dérives.
Rétention
La rétention fixe la durée de conservation de chaque copie. Trop courte, elle ne permet pas de remonter avant une corruption qui serait restée inaperçue plusieurs semaines. Trop longue, elle sature l’espace de stockage et finit par faire échouer les tâches de sauvegarde — un effet contre-intuitif mais classique : c’est en voulant tout garder qu’on cesse d’être protégé. Son suivi est donc à la fois un travail de conformité et un travail de capacité.
Restauration
La restauration est le seul moment où la protection démontre qu’elle existe. Elle peut être ciblée — un fichier, un disque — ou porter sur une machine virtuelle entière. Deux points comptent en exploitation : le catalogue doit être disponible et à jour, faute de quoi les données sauvegardées restent inaccessibles ; et la restauration doit avoir été testée, car un support illisible ou une tâche incomplète ne se découvrent jamais au bon moment.
Surveillance des opérations
La surveillance quotidienne porte sur quatre signaux : les tâches de sauvegarde (échecs, tâches en attente, durées qui s’allongent), l’état de la réplication (retard, interruption de liaison, groupe en erreur), la capacité (espace de la bibliothèque, profondeur du journal) et les écarts aux objectifs RPO et RTO.
Un principe guide ce travail : l’absence d’alerte ne vaut pas preuve de bon fonctionnement. Une tâche qui ne s’est jamais déclenchée ne produit pas d’échec — elle ne produit rien du tout, ce qui est plus difficile à voir qu’une erreur franche.
Risques et points de défaillance
| Point de défaillance | Conséquence | Signal à surveiller |
|---|---|---|
| Catalogue de sauvegarde indisponible | Données présentes mais non restaurables | Sauvegarde et état du CommServe |
| Journal de réplication saturé | Perte de la profondeur d’historique, retour limité au dernier état | Occupation du journal |
| Liaison WAN dégradée | Retard de réplication, RPO réel supérieur à l’objectif | Écart de réplication par groupe |
| Volume absent d’un groupe de cohérence | Reprise incohérente de l’application concernée | Composition des groupes |
| Bibliothèque de sauvegarde pleine | Tâches en échec, protection interrompue | Capacité et tendance d’occupation |
| Tâche non planifiée ou désactivée | Absence silencieuse de protection | Écart entre inventaire et tâches actives |
| Restauration jamais testée | Protection supposée, non démontrée | Fréquence et résultat des tests |
Réalisations
- Surveillance quotidienne de la réplication RecoverPoint, avec suivi des groupes de cohérence et traitement des anomalies détectées.
- Suivi des indicateurs RPO et RTO par groupe de cohérence, et signalement des écarts aux objectifs.
- Supervision des sauvegardes Commvault : suivi des tâches, relance ou escalade des échecs.
- Suivi des politiques de rétention appliquées aux ensembles de données protégés.
- Suivi des restaurations, de la demande jusqu’à la vérification du résultat.
- Supervision de l’infrastructure et du WAN régional avec PRTG, pour détecter les dégradations susceptibles d’affecter la protection.
- Documentation des opérations d’exploitation, au niveau d’exigence de la certification ISO 9001.
- Coordination des incidents avec la direction, en tant que responsable de division.
Compétences démontrées
| Domaine | Mise en œuvre sur ce mandat |
|---|---|
| Surveillance de la réplication | Exploitation quotidienne d’EMC RecoverPoint vers un site de reprise |
| Suivi des groupes de cohérence | Vérification de l’état et de la composition des groupes |
| Pilotage des objectifs de reprise | Suivi des indicateurs RPO et RTO, signalement des écarts |
| Supervision des sauvegardes | Suivi des tâches Commvault, traitement des échecs |
| Gestion des politiques de rétention | Suivi des durées de conservation appliquées |
| Suivi des restaurations | Accompagnement des demandes jusqu’à la vérification |
| Supervision d’infrastructure | PRTG sur l’infrastructure et le WAN régional |
| Exploitation sous contrainte d’audit | Procédures documentées, conformes aux exigences ISO 9001 |
Résultat
- Les deux mécanismes de protection étaient surveillés quotidiennement et les anomalies traitées ou escaladées.
- Les objectifs de reprise étaient suivis explicitement par groupe de cohérence, et non estimés après un incident.
- Les procédures d’exploitation étaient documentées, ce qui répond aux exigences de la certification ISO 9001.
- RPO et RTO : objectifs définis selon la criticité des services et suivis par mécanisme de protection.
- Écarts : analysés à partir des états de réplication, des tâches de sauvegarde et des alertes d’exploitation.
- Périmètre protégé : machines virtuelles et données relevant des services couverts par les mécanismes de protection.
- Tests de restauration : réalisés selon les procédures et fenêtres autorisées ; les résultats détaillés ne sont pas publiés.
- Groupes de cohérence : suivis selon le périmètre de réplication attribué, sans divulguer leur nombre ni leur nom.
Visuels et preuves
Les trois schémas ci-dessus sont des reconstitutions conceptuelles produites pour ce portfolio ; leurs sources sont versionnées avec le site.
Les schémas publiés décrivent les mécanismes de reprise sans exposer de tableau de bord, de nom de groupe, de volumétrie ou de donnée interne.